Agent Team là gì? Tổ chức đội ngũ tác nhân AI phân tích chứng khoán
Mùa công bố báo cáo tài chính quý 3 luôn là lúc khối lượng công việc tăng rất nhanh. Nếu theo dõi các mã trong rổ VN30, bạn cũng có thể phải đọc hàng chục báo cáo, đối chiếu các khoản mục, kiểm tra dòng tiền và tìm xem biến động lợi nhuận đến từ hoạt động kinh doanh hay một khoản bất thường.
Một cách quen thuộc là giao toàn bộ cho một trợ lý AI rồi để nó làm từ đầu đến cuối trong cùng một cuộc trò chuyện. Ban đầu cách này khá ổn. Nhưng khi số lượng báo cáo tăng lên, trợ lý phải mang theo quá nhiều bảng số, kết quả trung gian và bối cảnh của những mã đã xử lý. Đến một lúc nào đó, nhận xét bắt đầu chung chung hơn, hoặc một con số của mã này bị lẫn sang mã khác.
Vấn đề không hẳn là AI “kém đi”. Bộ nhớ làm việc của nó đã trở nên quá chật chội.
Khi nhắc đến việc giải quyết bài toán này, nhiều người nghĩ ngay đến khái niệm multi-agent đã xuất hiện được một thời gian dài trước đó: tạo ra vài chatbot đóng vai (role-playing) như AutoGen hay CrewAI rồi để chúng chat qua lại trong một vòng lặp. Nhưng trong thực tế làm việc với dữ liệu tài chính khắt khe, cách làm đó thường dẫn đến vòng lặp vô tận, ảo giác tập thể và rất khó kiểm soát.
Làn sóng công cụ AI Coding hiện đại gần đây — như Claude Code, OpenAI Codex và Google Antigravity — đã định hình lại cuộc chơi bằng khái niệm Agent Team (Đội ngũ tác nhân): một cấu trúc gồm tác nhân chính (Lead Agent) điều phối và các tác nhân phụ (Subagents) thực thi trong các không gian bộ nhớ độc lập, vận hành trên bộ khung Rules và Skills chặt chẽ.
Nhưng có một điểm cần nhìn rõ ngay từ đầu: xây dựng Agent Team không có nghĩa là gom càng nhiều AI càng tốt. Giá trị của một đội tác nhân nằm ở cách phân định ranh giới công việc, bộ nhớ làm việc độc lập và cơ chế kiểm chứng chéo sau cùng.
Ý chính: Agent Team giúp xử lý song song nhiều phần việc độc lập và tạo ra một lớp kiểm tra khách quan. Nó không tự làm cho một phân tích tốt hơn. Nếu chia việc sai, cả đội tác nhân chỉ làm sai nhanh hơn và tốn kém hơn.
Bài này nối tiếp Harness Engineering là gì trong AI phân tích chứng khoán và Trading Agents: tổ chức nhóm trợ lý AI. Nếu bài trước tập trung vào vai trò trong một nhóm nghiên cứu AI, bài này tập trung vào cách tổ chức Agent Team giữa các vai đó trong môi trường công cụ hiện đại.
Agent Team là gì? Từ một tác nhân đến một đội ngũ có tổ chức
Có thể hình dung ba mức độ tổ chức rất đơn giản.
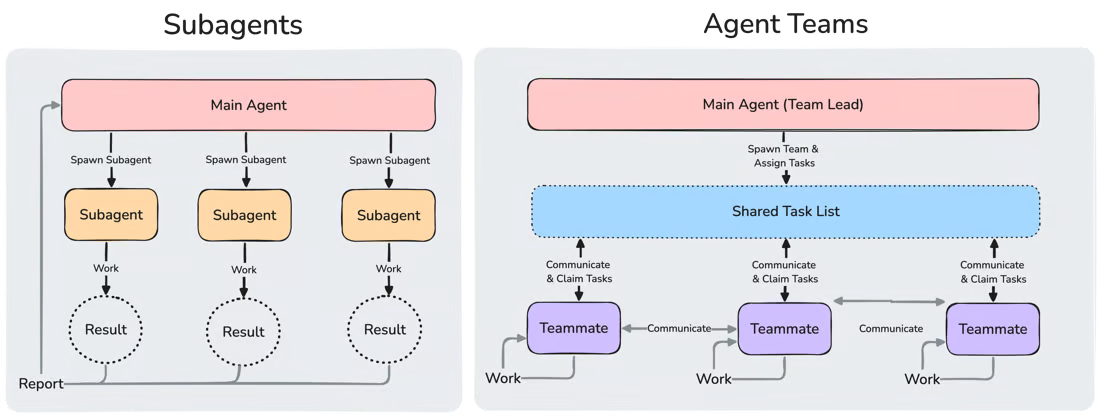 Cách tổ chức đa tác nhân AI. Nguồn: Anthropic
Một tác nhân nhận trọn nhiệm vụ, tự đọc dữ liệu, chạy chương trình, suy luận và viết kết quả. Đây là cách phù hợp với phần lớn công việc thông thường, đặc biệt khi quy mô chưa lớn.
Tác nhân phụ (subagents) nhận một phần việc tương đối độc lập từ tác nhân chính. Nó bắt đầu với bộ nhớ riêng, không thấy toàn bộ lịch sử cuộc trò chuyện chính và sau khi hoàn thành chỉ bàn giao kết quả. Vì vậy, tác nhân chính không phải mang theo toàn bộ những gì tác nhân phụ đã đọc.
Nhóm tác nhân (agent teams) đi thêm một bước: các thành viên có thể cùng nhìn bảng phân công và trao đổi trực tiếp với nhau. Cách này hữu ích khi bài toán không chỉ cần chia việc mà còn cần tranh luận, phản biện hoặc kiểm chứng chéo.
| Tác nhân phụ | Nhóm tác nhân | |
|---|---|---|
| Cách làm việc | Nhận việc rồi bàn giao | Vừa làm vừa trao đổi |
| Phù hợp | Việc độc lập | Việc cần phản biện |
| Điều phối | Tác nhân chính | Có thể có bảng việc chung |
| Chi phí | Thấp hơn | Cao hơn |
Điểm quan trọng nhất của tác nhân phụ chính là bộ nhớ riêng. Mỗi người chỉ phải tập trung vào phần việc của mình. Nhưng lợi thế này đồng thời tạo ra một rủi ro: nếu mỗi tác nhân hiểu dữ liệu hoặc quy tắc theo một cách khác nhau, việc ghép kết quả sẽ rất dễ phát sinh sai lệch.
Khi nào nên chia việc cho Agent Team?
Hai tài liệu được nhắc đến nhiều khi nói về vấn đề này xuất hiện gần như cùng thời điểm vào tháng 6/2025. Anthropic cho thấy đa tác nhân có thể cải thiện đáng kể những bài toán cần tìm kiếm và xử lý nhiều thông tin; trong khi Cognition cảnh báo rằng chia một sản phẩm chung cho nhiều tác nhân có thể tạo ra các mảnh kết quả không ăn khớp.12
Hai quan điểm này thực ra dẫn tới cùng một nguyên tắc: chỉ nên chia những phần việc đủ độc lập để mỗi tác nhân có thể tự đưa ra quyết định mà không phải liên tục chờ bối cảnh từ các tác nhân khác.
Anthropic ghi nhận hệ thống nghiên cứu của họ đạt kết quả tốt hơn tác nhân đơn lẻ trong bộ đánh giá nội bộ; đồng thời, lượng token sử dụng cũng tăng rất mạnh.1 Điều đó cho thấy lợi ích của đa tác nhân chủ yếu đến từ khả năng mở rộng lượng thông tin được xử lý, chứ không phải một phép màu khiến AI “thông minh hơn”.
Ngược lại, nếu chia một sản phẩm thành nhiều mảnh nhưng các mảnh phụ thuộc chặt chẽ vào nhau, chi phí truyền đạt bối cảnh có thể lớn hơn lợi ích nhận được. Cognition minh họa điều này bằng ví dụ các tác nhân cùng xây một trò chơi nhưng mỗi người tự hiểu phong cách theo một cách khác.2
Trong nghiên cứu chứng khoán, nguyên tắc này có thể áp dụng khá thẳng:
| Nên chia | Không nên chia |
|---|---|
| Đọc báo cáo của 30 mã độc lập | Nhiều tác nhân cùng viết một báo cáo ngành |
| Điều tra các giả thuyết khác nhau về một biến động | Nhiều tác nhân cùng sửa một phép tính hoặc một tệp |
| Một tác nhân phân tích, một tác nhân độc lập kiểm tra | Một chuỗi bước mà bước sau phụ thuộc toàn bộ chi tiết bước trước |
Vì vậy, hãy chia theo câu hỏi nghiên cứu, không phải chia theo số đoạn văn hay số dòng mã.
Ba lớp kiến trúc của một Agent Team: Rules, Skills và Subagents
Claude Code, Codex và Antigravity có cách tổ chức riêng ở cấp công cụ, nhưng nếu nhìn rộng hơn thì kiến trúc hiện nay đang tách thành ba lớp khá rõ.
Rules là những quy tắc nền tảng của dự án: cách đặt tên, giới hạn quyền, quy ước mã nguồn, ngày chốt dữ liệu hay những điều agent luôn phải tuân thủ. Đây vẫn là phần mang tính riêng của từng công cụ. Claude Code có CLAUDE.md, Codex dùng AGENTS.md, còn Antigravity có hệ thống rules riêng và vẫn hỗ trợ GEMINI.md.
Agent Skills là lớp khác. Skill đóng gói một cách làm việc có thể tái sử dụng: hướng dẫn, tài liệu tham khảo, script, mẫu dữ liệu và những quy trình chuyên môn. Quan trọng hơn, Agent Skills hiện đã trở thành một chuẩn mở để có thể mang cùng một skill giữa nhiều môi trường hỗ trợ agent, thay vì phải viết lại toàn bộ quy trình cho từng công cụ.3456
Subagent lại là chuyện khác nữa. Đây là một tác nhân được tách ra để nhận một phần việc cụ thể. Skill mô tả cách làm một việc; subagent là ai được giao làm việc đó; còn runtime của từng công cụ quyết định cách tạo, chạy và phối hợp các subagent.
Có thể hình dung đơn giản:
Quy tắc dự án
     │
     ├── Rules
     │     └── Những điều mọi agent phải tuân thủ
     │
     ├── Skills
     │     └── Cách thực hiện những loại công việc lặp lại
     │
     └── Subagents
           └── Tác nhân được giao từng phần việc
Điểm này quan trọng khi xây một hệ nghiên cứu dài hạn. Nếu bạn viết toàn bộ nghiệp vụ phân tích vào từng subagent, mỗi công cụ sẽ có một phiên bản hơi khác nhau và càng về sau càng khó bảo trì. Ngược lại, nếu đóng gói phần nghiệp vụ có thể tái sử dụng thành Skill, subagent của Claude Code, Codex hay Antigravity đều có thể dùng chung một “cách làm”.
Agent Skills hiện nằm ở đâu?
Ba công cụ đều hỗ trợ cấu trúc thư mục dựa trên SKILL.md:
| Công cụ | Skill theo dự án | Skill cá nhân |
|---|---|---|
| Claude Code | .claude/skills/<skill>/SKILL.md | ~/.claude/skills/<skill>/SKILL.md |
| Codex | .codex/skills/<skill>/SKILL.md | ~/.codex/skills/<skill>/SKILL.md |
| Antigravity | .agents/skills/<skill>/SKILL.md | ~/.gemini/config/skills/<skill>/SKILL.md |
Bên trong mỗi Skill có thể có thêm references/, scripts/, assets/ hoặc các tài nguyên khác. Chỉ phần tên và mô tả cần thiết được đưa vào bối cảnh ban đầu; phần hướng dẫn chi tiết và tài nguyên chỉ được đọc khi Skill thực sự được kích hoạt. Đây là một điểm rất đáng chú ý đối với những hệ thống có nhiều kiến thức nghiệp vụ, vì bạn không phải nhét toàn bộ tài liệu vào mọi cuộc trò chuyện.34
Antigravity còn đang chuyển hẳn khỏi mô hình Workflows cũ sang Agent Skills. Google đã thông báo Workflows sẽ bị loại bỏ sau ngày 01/11/2026, và khuyến nghị chuyển sang Skills vì đây là định dạng mở, hỗ trợ nạp nội dung theo nhu cầu và có thể đóng gói cả script lẫn tài liệu liên quan.6
Điều đó không có nghĩa GEMINI.md biến mất. Nó vẫn có vai trò ở lớp Rules. Chỉ là không nên dùng nó để đại diện cho một quy trình hay năng lực chuyên môn có thể tái sử dụng. Hai lớp này nên được tách riêng.
Còn subagent thì sao?
Subagent vẫn rất quan trọng với bài toán đa tác nhân. Nhưng đây là phần mà bạn phải chấp nhận một ít khác biệt giữa các công cụ.
Claude Code cho phép định nghĩa subagent riêng trong .claude/agents/, mỗi subagent có mô tả, prompt, quyền dùng công cụ và có thể được gắn Skill phù hợp. Codex cũng hỗ trợ các agent tùy chỉnh trong .codex/agents/, cùng những vai dựng sẵn như worker và explorer. Antigravity có thư mục agents/ riêng bên cạnh skills/ và rules/.789
Vì vậy, khi xây một hệ thống nghiên cứu đa tác nhân, phần nên chuẩn hóa và tái sử dụng là nghiệp vụ và quy trình; phần điều phối nhiều tác nhân thì để runtime của từng công cụ đảm nhiệm.
Đây cũng là cách tránh một cái bẫy khá phổ biến: cố biến một file subagent thành “bộ não” chứa tất cả mọi thứ. Càng làm như vậy, bạn càng khóa hệ thống vào một công cụ cụ thể.
Đặc thù chứng khoán Việt Nam: nơi các tác nhân rất dễ hiểu khác nhau
Đây mới là phần quyết định chất lượng của hệ thống.
Trong nghiên cứu chứng khoán, các tác nhân có thể làm đúng phần việc của mình nhưng vẫn tạo ra một bảng tổng hợp sai vì mỗi người ngầm hiểu dữ liệu theo một cách khác. Những khác biệt thường gặp gồm:
- Hợp nhất hay riêng lẻ: một tác nhân lấy số hợp nhất, tác nhân khác lấy số riêng lẻ.
- Quý, bán niên soát xét, năm kiểm toán: cùng một chỉ tiêu có thể thay đổi giữa các phiên bản báo cáo.
- Ngày kết thúc kỳ và ngày công bố: khi phân tích một thời điểm trong quá khứ, ngày công bố mới là mốc để kiểm soát thông tin.
- Khác biệt ngành: ngân hàng, chứng khoán và bảo hiểm có cấu trúc báo cáo khác doanh nghiệp sản xuất; không thể dùng chung một bộ chỉ tiêu.
- Đơn vị: đồng, triệu đồng và tỷ đồng có thể xuất hiện trong cùng hệ thống nguồn.
- Giá điều chỉnh: nếu dùng giá chưa điều chỉnh, ngày giao dịch không hưởng quyền có thể tạo ra những biến động giả trên chuỗi giá.
- Đặc thù sàn: biên độ và thanh khoản trên HOSE, HNX, UPCoM khác nhau; một số mã UPCoM còn có phiên không phát sinh khớp lệnh.
- Tin tức: khi dựng lại một bức tranh của quá khứ, thông tin được công bố sau ngày chốt không được phép lọt vào phân tích.
Những quy tắc này không nên được nhắc lại riêng trong từng lời giao việc. Chúng nên nằm trong một bộ quy tắc chung của dự án, để mọi tác nhân cùng bắt đầu từ một cách hiểu giống nhau.
Ví dụ:
# Quy tắc chung cho dự án nghiên cứu

- Mặc định dùng báo cáo HỢP NHẤT; dùng riêng lẻ phải ghi rõ lý do.
- Ghi rõ kỳ báo cáo, loại báo cáo và ngày công bố.
- Chuẩn hoá đơn vị về tỷ đồng; giữ đơn vị gốc của nguồn.
- Dùng giá điều chỉnh cho các phép tính lợi suất.
- Ngân hàng, chứng khoán, bảo hiểm dùng bộ chỉ tiêu riêng.
- Không sử dụng thông tin công bố sau ngày chốt.

Mọi tác nhân phải bàn giao:
1. Bảng dữ kiện có thông tin nguồn cụ thể.
2. Cung cấp nhận xét ngắn gọn gắn với dữ kiện.
3. Điều chưa chắc chắn hoặc điểm cần kiểm tra thêm.
Với Claude Code, nội dung này có thể đặt trong CLAUDE.md; với Codex là AGENTS.md; với Antigravity là quy tắc chung của dự án.
Bàn giao quan trọng hơn việc có bao nhiêu tác nhân
Nhiều người khi bắt đầu với đa tác nhân thường tập trung vào câu hỏi “cần bao nhiêu tác nhân?”. Theo mình, câu hỏi quan trọng hơn là: một tác nhân cần bàn giao lại những gì để người tiếp nhận không hiểu sai kết quả?
Hãy lấy một trường hợp đơn giản. Một ngân hàng có lợi nhuận quý tăng 60%, nhưng phần lớn mức tăng đến từ hoàn nhập dự phòng. Nếu tác nhân phụ chỉ bàn giao câu “lợi nhuận tăng 60%”, không có con số nào sai, nhưng tác nhân chính hoàn toàn có thể diễn giải thành “hoạt động kinh doanh cốt lõi tăng trưởng mạnh”.
Đây là kiểu lỗi nguy hiểm trong nghiên cứu: dữ kiện đúng nhưng câu chuyện sai.
Vì vậy, một lời giao việc tốt nên xác định ít nhất bốn thứ: mục tiêu cần trả lời, định dạng đầu ra, nguồn/công cụ được phép sử dụng và ranh giới của công việc.1
Một mẫu bàn giao đơn giản có thể là:
## Bảng dữ kiện
| Mã | Chỉ tiêu | Giá trị | Đơn vị | Kỳ | Loại báo cáo | Ngày công bố | Nguồn |

## Nhận xét
Tối đa 3 câu, mỗi câu phải truy ngược được về dữ kiện.

## Điều chưa chắc
- Biến động lớn nhưng chưa xác định được nguyên nhân.
- Hai nguồn cho số khác nhau.
- Báo cáo chưa được soát xét hoặc kiểm toán.
Phần “điều chưa chắc” rất đáng giữ lại. Một tác nhân vừa đọc hàng chục trang mà không tìm thấy bất kỳ điểm nào cần kiểm tra chưa chắc đã là tín hiệu tốt.
Ba mô hình bố trí Agent Team trong nghiên cứu
Có thể quy về ba mô hình chính: chia việc hàng loạt, để các giả thuyết cạnh tranh, và giữ quy trình tuần tự nhưng tách riêng người kiểm tra. Tuỳ thuộc vào tính chất độc lập của dữ liệu hay mức độ phức tạp của bài toán, bạn có thể áp dụng từng mô hình hoặc kết hợp chúng lại với nhau.
1. Chia việc hàng loạt
Đây là mô hình tự nhiên nhất trong mùa báo cáo. Chẳng hạn 30 mã được chia thành sáu nhóm, mỗi tác nhân phụ xử lý năm mã rồi bàn giao theo cùng một mẫu.
Mô hình chia việc hàng loạt: trưởng nhóm phân phối các đối tượng độc lập cho các tác nhân phụ chạy song song, sau đó gom về một bảng tổng hợp chuẩn hoá.
Cách này hiệu quả vì các mã gần như độc lập. Tác nhân phụ xử lý HPG không cần biết tác nhân khác vừa kết luận gì về FPT; chỉ cần tất cả cùng tuân thủ một bộ quy tắc và một định dạng đầu ra.
Nên chia theo đặc thù ngành khi điều đó giúp tác nhân dùng đúng bộ chỉ tiêu. Với những việc chỉ cần đọc và trích dữ kiện, có thể dùng mô hình nhỏ hơn; phần tổng hợp và suy luận cuối cùng nên dành cho mô hình mạnh hơn.1
2. Giả thuyết cạnh tranh
Mô hình này phù hợp khi bạn biết “có chuyện gì đó” nhưng chưa biết nguyên nhân.
Lợi nhuận tăng đột biến chẳng hạn có thể đến từ hoạt động cốt lõi, hoàn nhập dự phòng, thoái vốn, bán tài sản, chênh lệch tỷ giá hoặc một thay đổi trong cách ghi nhận. Thay vì để một tác nhân tìm lời giải thích đầu tiên nghe có vẻ hợp lý, mỗi tác nhân có thể điều tra một giả thuyết và chủ động tìm cả bằng chứng ủng hộ lẫn bằng chứng bác bỏ.
Mô hình giả thuyết cạnh tranh: hai tác nhân độc lập bảo vệ các giả định đối lập và phản biện chéo nhau trước khi tổng hợp thành bảng bằng chứng.
Đây là lúc nhóm tác nhân có lợi thế hơn mô hình chỉ chia việc, bởi các thành viên thực sự cần phản biện nhau.4 Nếu công cụ chưa có nhóm tác nhân, vẫn có thể làm theo hai vòng: vòng đầu điều tra các giả thuyết, vòng sau giao toàn bộ kết quả cho một tác nhân mới chỉ làm nhiệm vụ phản biện.
Đầu ra nên là bảng bằng chứng, không phải một câu “giả thuyết A đúng”.
3. Làm chính rồi kiểm tra độc lập
Một quy trình nghiên cứu thường có tính tuần tự: truy xuất → kiểm dữ liệu → tính toán → viết. Vì các bước phụ thuộc nhau, tách mỗi bước cho một tác nhân khác thường không mang lại nhiều lợi ích.
Điều đáng tách ra là khâu kiểm tra cuối.
Mô hình làm chính + kiểm tra độc lập: tác nhân chính tự do phân tích và tạo dự thảo, sau đó tác nhân kiểm tra với bộ nhớ riêng soát xét độc lập trước khi hoàn tất.
Tác nhân đã tự làm toàn bộ quy trình dễ bị ảnh hưởng bởi chính mạch suy luận của nó. Một tác nhân phụ bắt đầu với bộ nhớ riêng, chỉ nhận báo cáo cuối và dữ liệu gốc, có thể chọn ngẫu nhiên một số con số quan trọng để tính lại, kiểm tra ngày công bố, đơn vị và loại báo cáo.
Ở đây, việc tác nhân kiểm tra không biết quá trình làm trước đó lại trở thành một ưu điểm: nó có thể nhìn kết quả mà không bị ràng buộc bởi kết luận ban đầu.
Chọn mô hình nào?
| Mô hình | Dùng khi | Cách phù hợp |
|---|---|---|
| Chia việc hàng loạt | Nhiều đối tượng độc lập | Tác nhân phụ |
| Giả thuyết cạnh tranh | Nhiều cách giải thích cần kiểm chứng | Nhóm tác nhân hoặc hai vòng tác nhân phụ |
| Làm chính + kiểm tra | Quy trình tuần tự | Một tác nhân chính + một tác nhân phụ |
Ba mô hình này cũng có thể kết hợp trong cùng một quy trình.
Thực hành: đóng gói nghiệp vụ trước, rồi mới giao cho tác nhân
Nếu muốn áp dụng cách này vào một quy trình nghiên cứu thật, mình sẽ không bắt đầu bằng việc tạo thật nhiều subagent. Hãy bắt đầu từ thứ có thể dùng lại lâu dài: đóng gói quy trình nghiên cứu thành Skill.
Ví dụ, quy trình “soát số liệu” có thể được viết thành:
.agents/skills/soat-so-lieu/
├── SKILL.md
├── references/
│   └── quy-tac-du-lieu.md
└── scripts/
    └── kiem-tra-so-lieu.py
SKILL.md có thể chứa phần hướng dẫn cốt lõi:
---
name: soat-so-lieu
description: Kiểm tra số liệu trong báo cáo nghiên cứu cổ phiếu bằng cách đối chiếu với dữ liệu gốc. Dùng khi cần xác minh các con số quan trọng trước khi phát hành báo cáo.
---

# Soát số liệu nghiên cứu

1. Đọc quy tắc dữ liệu chung của dự án.
2. Chọn ít nhất 5 con số quan trọng trong báo cáo.
3. Tính lại từ dữ liệu gốc và ghi rõ công thức.
4. Kiểm tra ngày công bố, đơn vị và loại báo cáo.
5. Ghi lại mọi chênh lệch và điểm chưa chắc.
6. Kết luận ĐẠT hoặc CẦN SỬA.

Không sửa báo cáo. Không tự ý bổ sung dữ liệu ngoài nguồn được chỉ định.
Nếu cần, script Python có thể đảm nhiệm phần tính toán lặp lại; tài liệu chi tiết về quy tắc báo cáo có thể để trong references/. Chính cách tổ chức này giúp Skill vừa dễ đọc, vừa không làm phình bối cảnh của agent ngay từ đầu.34
Sau đó, Claude Code, Codex hoặc Antigravity có thể dùng cùng một quy trình theo cơ chế Skill của mình. Khi cần một tác nhân chuyên trách, bạn tạo subagent cho vai soát số liệu và cho nó sử dụng Skill đó.
Kiến trúc lúc này tách rất rõ:
Skill: soát số liệu
        │
        ├── quy tắc nghiệp vụ
        ├── cách kiểm tra
        ├── script tính toán
        └── mẫu kết quả
        │
        ▼
Subagent: người soát số liệu
        │
        ▼
Runtime: Claude Code / Codex / Antigravity
Cách làm này đáng tin cậy hơn việc sao chép cùng một đoạn prompt vào ba file subagent khác nhau. Khi quy tắc tính toán thay đổi, bạn chỉ sửa Skill; các tác nhân sử dụng Skill đó có thể tiếp tục dùng cùng một quy trình.
Một quy trình mùa báo cáo có thể vì thế khá gọn:
1. Tải toàn bộ dữ liệu về du-lieu/ một lần.
2. Chia danh sách thành các nhóm độc lập.
3. Giao từng nhóm cho các subagent phù hợp.
4. Tất cả cùng dùng chung Rules và các Skills cần thiết.
5. Agent chính tổng hợp kết quả.
6. Một subagent khác chạy Skill "soát số liệu" để kiểm tra bảng cuối.
Bước đầu tiên vẫn đáng giữ. Nếu sáu tác nhân đồng thời tự gọi nguồn bên ngoài, bạn vừa tạo thêm tải, vừa tăng khả năng mỗi tác nhân nhìn thấy một trạng thái dữ liệu khác nhau.
5 Cạm bẫy khi vận hành Agent Team tài chính
Thêm tác nhân không đồng nghĩa với thêm độ tin cậy. Có ít nhất năm kiểu lỗi nên đặc biệt cảnh giác.
Đồng thuận giả. Năm tác nhân cùng một mô hình, đọc cùng một dữ liệu và đi đến cùng một kết luận chưa phải là năm ý kiến độc lập. Muốn phản biện thật, tác nhân kiểm tra phải có mục tiêu khác với tác nhân viết: tìm điểm yếu, kiểm chứng lại số liệu hoặc thậm chí dùng một mô hình khác.
Sai số lan truyền. Nếu một con số sai ngay từ bước truy xuất, các tầng sau có thể tiếp tục sử dụng nó. Vì vậy, kiểm dữ liệu nên nằm gần đầu quy trình, không chỉ ở cuối.
Tóm tắt làm mất điều kiện. “Lợi nhuận tăng 60%” và “lợi nhuận tăng 60% chủ yếu nhờ hoàn nhập dự phòng” là hai thông tin rất khác nhau. Mẫu bàn giao phải buộc giữ lại nguyên nhân và những điểm chưa chắc.
Thông tin của tương lai lọt vào. Khi phân tích lại một thời điểm trong quá khứ, tác nhân đọc web rất dễ gặp bài viết hoặc công bố xuất hiện sau ngày chốt. Ngày công bố phải là dữ kiện được kiểm tra, không phải một chi tiết trang trí.
Chỉ dẫn lạ đi theo dữ liệu. Nội dung trên trang web hay trong PDF có thể chứa các câu giống như mệnh lệnh. Tác nhân phải coi chúng là dữ liệu, không phải chỉ dẫn. Quyền ghi tệp, chạy lệnh hoặc thực hiện hành động bên ngoài cũng nên được giới hạn theo đúng vai trò.4
Và có một nguyên tắc không nên thỏa hiệp: nhóm nghiên cứu không cần quyền đặt lệnh hay chuyển tiền. Hệ thống có thể kết thúc bằng một bản ghi nhớ; quyết định vẫn thuộc về con người.
Vnstock đóng vai trò gì trong Agent Team nghiên cứu?
Trong kiến trúc này, các tác nhân cần một lớp dữ liệu chung để truy xuất và chuẩn hoá. Vnstock có thể đảm nhận phần đó: kết nối dữ liệu thị trường từ các nguồn bên thứ ba, đưa về một lớp sử dụng thống nhất để các tác nhân không phải tự tìm nguồn và tự đặt tên trường theo những cách khác nhau.
Agent Guide và Agent Skills giúp tác nhân — kể cả tác nhân phụ bắt đầu với bộ nhớ riêng — biết nên dùng công cụ nào mà không phải đọc toàn bộ tài liệu. Xem thêm cách Vnstock làm việc với AI Agent, Agent Skills là gì, cùng Lộ trình học Vibe Coding bài bản cho người mới và Tài liệu Vnstock Agent Guide.
Nhưng Vnstock không thay thế thiết kế quy trình. Nó cũng không tự quyết định ý nghĩa của một con số hay bảo đảm mọi nguồn đều có cùng độ chính xác. Lớp dữ liệu chỉ giúp giảm một phần những khác biệt không cần thiết giữa các tác nhân; phần kiểm chứng vẫn thuộc về hệ thống nghiên cứu của bạn.
Bài học rút ra khi xây dựng Agent Team
Một hệ đa tác nhân tốt không bắt đầu bằng câu hỏi “có thể chạy bao nhiêu AI cùng lúc?”. Nó bắt đầu bằng câu hỏi: phần việc nào thực sự độc lập, thông tin nào phải được thống nhất và ai sẽ kiểm tra kết quả?
Nếu công việc đang quá tải, hãy thử tách những phần độc lập. Nếu một kết luận có nhiều cách giải thích, hãy dùng phản biện chéo. Nếu quy trình đã ổn, thêm một tác nhân kiểm tra độc lập thường có giá trị hơn việc thêm một tác nhân nữa cùng làm.
Với nghiên cứu chứng khoán Việt Nam, còn một nguyên tắc quan trọng hơn: mọi tác nhân phải cùng hiểu kỳ báo cáo, loại báo cáo, đơn vị, ngày chốt thông tin và đặc thù ngành. Không thống nhất được những điều đó thì càng nhiều tác nhân chỉ càng làm sai nhanh hơn.
Điểm cốt lõi của đa tác nhân, vì vậy, không phải là “nhân bản AI”. Đó là thiết kế một quy trình mà mỗi tác nhân chỉ phải làm đúng phần việc của mình, còn toàn hệ thống vẫn giữ được một sự thật chung để có thể kiểm chứng từ đầu đến cuối.
Câu hỏi thường gặp
Agent Team trong Claude Code hay Antigravity khác gì các framework Multi-Agent cũ như AutoGen hay CrewAI?
Các framework multi-agent thế hệ 2023–2024 chủ yếu cho các chatbot đóng vai (role-playing) và nhắn tin qua lại trong một cửa sổ trò chuyện chung; mô hình này dễ bị lặp vô tận, trôi bối cảnh và thiếu khả năng kiểm soát dữ liệu thực tế. Ngược lại, Agent Team trong các công cụ agentic coding hiện đại (Claude Code, OpenAI Codex, Google Antigravity) phân tách ranh giới kỹ thuật rất rõ:
- Tách biệt bộ nhớ (Process & Context Isolation): Mỗi subagent chạy trong không gian riêng, chỉ thấy dữ liệu được giao và chỉ trả về kết quả cần thiết, không làm phình ngữ cảnh của tác nhân chính.
- Tương tác trực tiếp với môi trường: Tác nhân có quyền đọc ghi tệp, chạy script Python, truy vấn API và tương tác với terminal thật.
- Tiêu chuẩn hoá qua Rules và Skills: Thay vì nhét prompt dài dòng, Agent Team vận hành dựa trên quy tắc dự án (
CLAUDE.md,AGENTS.md) và các kỹ năng tái sử dụng (SKILL.md).
Tác nhân phụ (Subagent) và Nhóm tác nhân (Agent Team) khác nhau thế nào?
Tác nhân phụ nhận một phần việc và bàn giao lại cho tác nhân chính. Nhóm tác nhân cho phép các thành viên phối hợp và phản biện trực tiếp. Với phần lớn nghiên cứu có các nhiệm vụ độc lập, tác nhân phụ thường đã đủ.
Có cần biết lập trình để dùng đa tác nhân không?
Không nhiều. Phần khó hơn nằm ở nghiệp vụ: xác định dữ liệu nào là đúng, chia công việc ở đâu và yêu cầu đầu ra thế nào. Cú pháp cấu hình có thể học sau.
Nên bắt đầu với bao nhiêu tác nhân?
Một tác nhân chính cộng một tác nhân kiểm tra là điểm khởi đầu hợp lý. Chỉ tăng số lượng khi có nhiều phần việc độc lập thật sự hoặc một bài toán cần tranh luận giữa các giả thuyết.14
Nhiều tác nhân có làm kết quả đầu tư tốt hơn không?
Không có bảo đảm như vậy. Đa tác nhân giúp mở rộng lượng công việc được xử lý và tạo thêm cơ chế kiểm tra, nhưng không biến dữ liệu sai thành đúng hay một giả định yếu thành một kết luận đáng tin. Kết quả vẫn cần được con người kiểm chứng trước khi sử dụng cho quyết định đầu tư.
Tài liệu tham khảo
—
Vnstock là hệ sinh thái công cụ Python chạy trên hạ tầng của bạn: kết nối, chuẩn hoá và phân tích dữ liệu thị trường từ nguồn bên thứ ba. Vnstock cấp quyền dùng phần mềm, không bán dữ liệu; tính sẵn sàng và độ chính xác phụ thuộc nguồn. Nội dung phục vụ nghiên cứu và tham khảo, không phải khuyến nghị đầu tư.
Footnotes
-
Anthropic, How we built our multi-agent research system, 13/06/2025. ↩ ↩2 ↩3 ↩4 ↩5
-
Walden Yan, Don't Build Multi-Agents, Cognition, 12/06/2025. ↩ ↩2
-
Anthropic, Agent Skills. ↩ ↩2 ↩3
-
Google Antigravity, Agent Skills và Migrate from Workflows to Skills. ↩ ↩2
-
Anthropic, Claude Code — Create custom subagents. ↩
-
OpenAI, Codex — Subagents. ↩
-
Google Antigravity, Subagents / Agents. ↩