Mẫu Chương trình Cập nhật Tin tức
Mục lục
Bản mặc định hiện là vnstock_news v3.1.1, gộp bản Cộng đồng và bản Mở rộng vào một thư viện. Trang này giữ lại cho máy còn cài vnstock_news v2.2.2: mã viết theo trang này vẫn chạy với bản đó. Đã cài bản mới thì đọc trang tương ứng của v3.1.1.
Máy đang cài bản nào: chạy python -c "import vnstock; print(vnstock.__version__)", ra số bắt đầu bằng 5. là thế hệ 5.
vnstock_news, từ việc kiểm thử nhanh qua dòng lệnh đến việc xây dựng các kịch bản Python ghi log, lọc bài trùng lặp và đọc danh mục bài viết từ sitemap với tần suất hợp lý.
Sử dụng qua Dòng Lệnh (CLI)
Sau khi cài đặt vnstock_news, bạn có thể chạy chương trình theo dõi tin tức trực tiếp từ dòng lệnh Terminal để kiểm thử quá trình theo dõi tin và lưu kết quả:
vnstock-news-crawlerBạn có thể xem thêm tài liệu Agent Guide bên dưới để hướng dẫn các công cụ AI Agent (Google Antigravity, Claude Code, Cursor) viết kịch bản theo dõi tin tức theo yêu cầu.
 Khởi động chương trình Vnstock News từ Terminal của macOS
Khi khởi chạy, chương trình đọc nguồn cấp tin (RSS) và sơ đồ trang (sitemap) do các trang tin công bố, lọc bài theo khoảng thời gian yêu cầu và lưu kết quả dưới dạng tập tin CSV tại thư mục output.
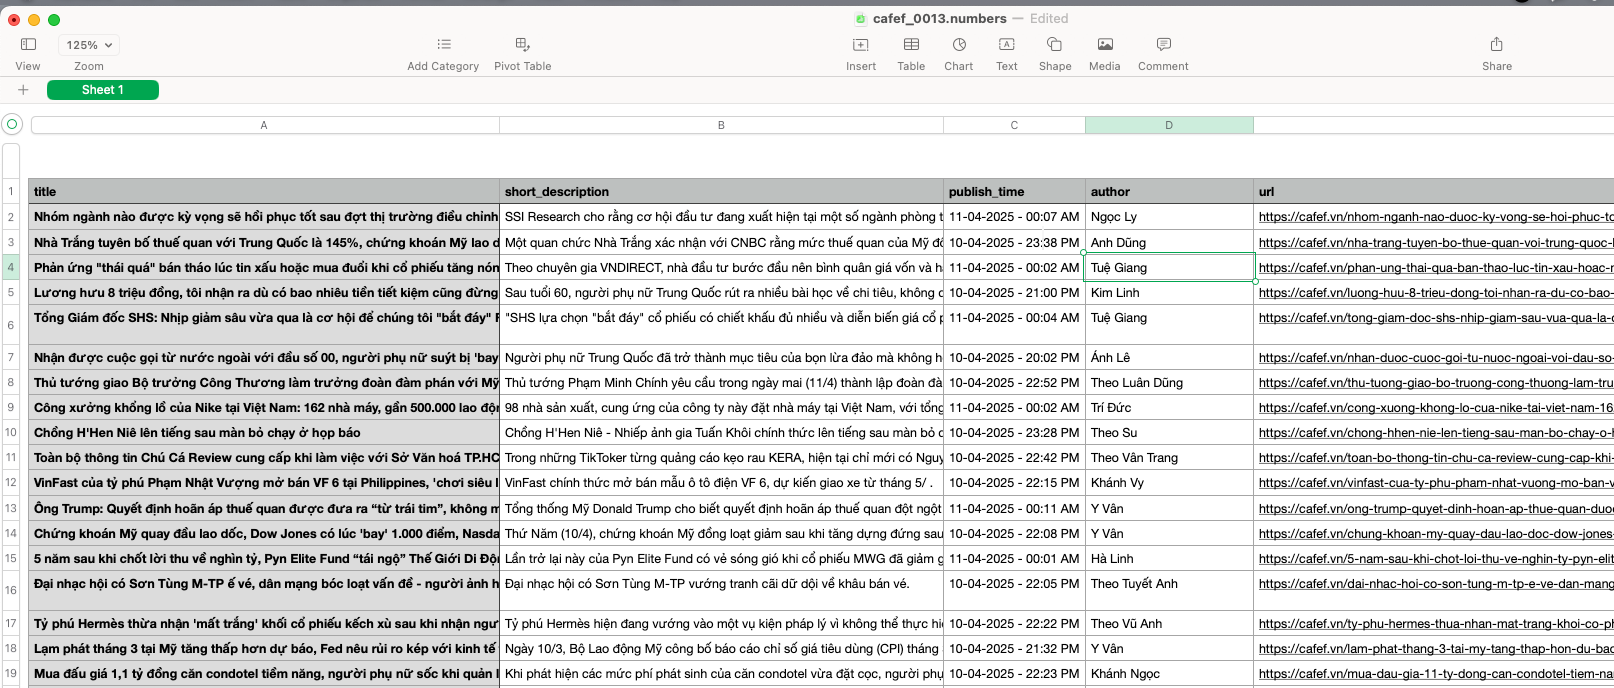 Nội dung dữ liệu tin tức được chuẩn hoá từ Vnstock News
Khung báo cáo sau thống kê sẽ xuất về tệp tĩnh mang tên news_summary.txt:
News Monitor Report - 2026-04-15
==================================================

STATISTICS
--------------------------------------------------
Total articles collected: 580

TRENDING TOPICS
--------------------------------------------------
1. chứng khoán: 107 mentions
2. thị trường: 76 mentions
3. lãi suất: 45 mentions
...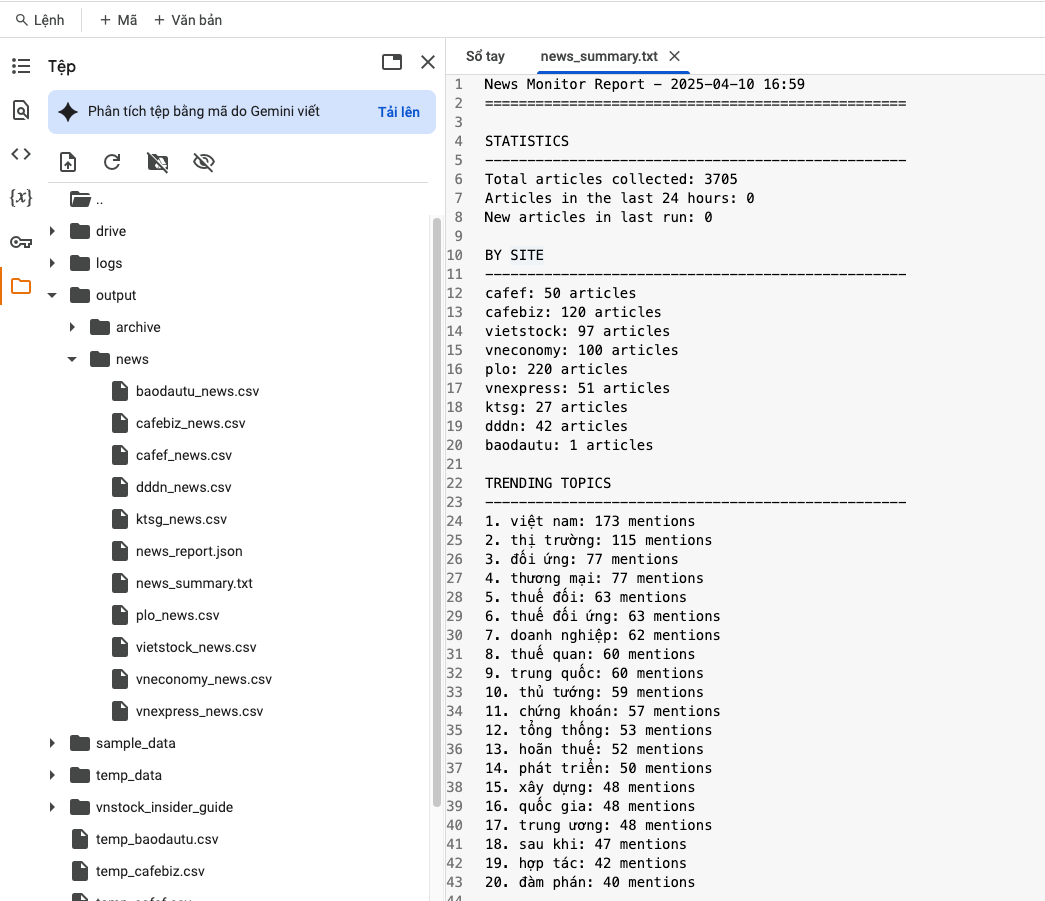 Tóm tắt kết quả chương trình khi kết nối và phân tích tin tức trên Google Colab
Kịch Bản Python 1: Cập Nhật Tin Tức Định Kỳ Qua RSS Feed
Kịch bản Python dưới đây vận hành luồng kiểm tra tin mới định kỳ, ghi log quá trình chạy và lọc bài viết trùng lặp để tránh lưu lại bài viết đã nhận trước đó.
import os
import time
import logging
from datetime import datetime
import pandas as pd
from vnstock_news import Crawler

# Cấu hình ghi log hệ thống
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(name)s - %(message)s",
    handlers=[
        logging.FileHandler("news_monitor.log", encoding="utf-8"),
        logging.StreamHandler()
    ]
)
logger = logging.getLogger("PeriodicNewsMonitor")

class PeriodicNewsMonitor:
    def __init__(self, target_sites: list, poll_interval_seconds: int = 900, output_dir: str = "./news_data"):
        self.target_sites = target_sites
        self.poll_interval = poll_interval_seconds
        self.output_dir = output_dir
        self.seen_urls = set()

        os.makedirs(self.output_dir, exist_ok=True)
        logger.info(f"Đã khởi tạo bộ theo dõi tin tức cho các nguồn: {self.target_sites}")

    def poll_once(self) -> int:
        """Thực hiện một lượt quét tin mới từ danh sách RSS feeds."""
        collected_articles = []

        for site in self.target_sites:
            try:
                logger.info(f"Đang kiểm tra RSS feed từ: {site}")
                client = Crawler(site_name=site)
                articles = client.get_articles_from_feed(limit_per_feed=15)

                new_in_site = 0
                for item in articles:
                    url = item.get("url")
                    if url and url not in self.seen_urls:
                        self.seen_urls.add(url)
                        collected_articles.append(item)
                        new_in_site += 1

                logger.info(f"[{site}] Phát hiện {new_in_site} tin bài mới.")
            except Exception as e:
                logger.error(f"Lỗi khi truy xuất tin từ site '{site}': {e}", exc_info=True)

        # Lưu tin bài mới ra file CSV theo ngày nếu có dữ liệu mới
        if collected_articles:
            df = pd.DataFrame(collected_articles)
            today_str = datetime.now().strftime("%Y-%m-%d")
            filename = os.path.join(self.output_dir, f"daily_news_{today_str}.csv")

            # Ghi nối tiếp (append) vào file CSV nếu file đã tồn tại
            file_exists = os.path.exists(filename)
            df.to_csv(filename, mode="a", index=False, header=not file_exists, encoding="utf-8-sig")
            logger.info(f"Đã ghi nhận và lưu {len(collected_articles)} bài viết mới vào: {filename}")

        return len(collected_articles)

    def start_periodic_monitoring(self):
        """Khởi chạy vòng lặp cập nhật định kỳ."""
        logger.info(f"Khởi chạy vòng lặp cập nhật định kỳ (chu kỳ: {self.poll_interval}s)...")
        try:
            while True:
                total_new = self.poll_once()
                logger.info(f"Hoàn thành chu kỳ. Tổng tin bài mới truy xuất: {total_new}. Chờ chu kỳ tiếp theo sau {self.poll_interval}s...")
                time.sleep(self.poll_interval)
        except KeyboardInterrupt:
            logger.info("Đã nhận tín hiệu dừng từ người dùng (Ctrl+C). Dừng an toàn.")

if __name__ == "__main__":
    # Khởi tạo monitor cho các nguồn có RSS (VnExpress, Tuổi Trẻ, Thanh Niên)
    monitor = PeriodicNewsMonitor(
        target_sites=["vnexpress", "tuoitre", "thanhnien"],
        poll_interval_seconds=900,  # Kiểm tra định kỳ mỗi 15 phút, giữ tần suất hợp lý với website nguồn
        output_dir="./output_stream"
    )

    # Thực hiện 1 lượt kiểm tra ngay lập tức
    monitor.poll_once()
Kịch Bản Python 2: Đọc Danh Mục Bài Viết Từ Sitemap
Khi cần lập tập dữ liệu bài viết phục vụ nghiên cứu, kịch bản dưới đây dùng EnhancedNewsCrawler để đọc dữ liệu từ sitemap, có bộ nhớ đệm để tránh gửi lại yêu cầu cho bài đã có, giới hạn số kết nối đồng thời và làm sạch nội dung văn bản. Hãy chỉ lấy số lượng bài thật sự cần thiết và điều phối tần suất phù hợp:
import asyncio
import logging
from vnstock_news import EnhancedNewsCrawler

# Cấu hình logging
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("BatchPipeline")

async def run_batch_extraction_pipeline():
    logger.info("Khởi động quy trình đọc danh mục bài viết từ sitemap...")

    # Khởi tạo EnhancedNewsCrawler với bộ nhớ đệm SQLite
    client = EnhancedNewsCrawler(
        cache_enabled=True,
        cache_type="sqlite",
        cache_ttl=86400,    # Đệm dữ liệu trong 24 giờ
        max_concurrency=3   # Tối đa 3 yêu cầu đồng thời; giữ mức thấp để tôn trọng máy chủ nguồn
    )

    # Danh sách sitemap mục tiêu từ các website tin tức tài chính
    sitemap_sources = [
        "https://cafef.vn/latest-news-sitemap.xml",
        "https://tuoitre.vn/news-sitemap.xml"
    ]

    logger.info("Bắt đầu truy xuất bất đồng bộ từ Sitemap sources...")
    df_corpus = await client.fetch_articles_async(
        sources=sitemap_sources,
        site_name="cafef",
        max_articles=50,
        clean_content=True  # Tự động loại bỏ HTML thừa, quảng cáo
    )

    if not df_corpus.empty:
        logger.info(f"Đã trích xuất và chuẩn hóa thành công {len(df_corpus)} bài viết.")

        # Xem thông tin dữ liệu
        print("\n--- THÔNG TIN BỘ DỮ LIỆU ---")
        print(df_corpus.info())
        print("\n--- MẪU 3 BÀI VIẾT ĐẦU TIÊN ---")
        print(df_corpus[["title", "author", "publish_time", "source"]].head(3))

        # Xuất dữ liệu ra file CSV
        output_file = "news_corpus_batch_export.csv"
        df_corpus.to_csv(output_file, index=False, encoding="utf-8-sig")
        logger.info(f"Dữ liệu đã được xuất ra file: {output_file}")
    else:
        logger.warning("Không truy xuất được dữ liệu bài viết nào từ nguồn sitemap đã cho.")

if __name__ == "__main__":
    asyncio.run(run_batch_extraction_pipeline())
Các kịch bản trên hỗ trợ thiết lập quy trình theo dõi tin tức phục vụ nhu cầu cá nhân. Người dùng nên đặt khoảng cách thời gian hợp lý giữa các yêu cầu, tuân thủ hướng dẫn trong robots.txt và điều khoản sử dụng của từng website. Bản quyền nội dung và hình ảnh thuộc về đơn vị xuất bản chủ quản.