Schema dữ liệu là gì? Bản đồ để code và AI hiểu dữ liệu
Bạn nhờ AI viết một đoạn Python lấy giá lịch sử, tính đường trung bình rồi lưu kết quả. Chương trình chạy được. Vài tuần sau, nguồn dữ liệu đổi tên cột ticker thành symbol, chuyển thời gian từ chuỗi sang một kiểu ngày giờ khác hoặc bắt đầu trả thêm giá trị null. Đoạn code cũ có thể báo lỗi ngay, nhưng cũng có thể tiếp tục chạy và cho ra một kết quả sai mà không ai nhận ra.
Vấn đề không nằm ở việc AI viết Python kém. AI cũng như lập trình viên đang thiếu một bản mô tả đủ rõ về đặc điểm mà dữ liệu phải tuân theo.
Bản mô tả đó được gọi là schema dữ liệu. Nếu data contract là bản quy ước để các bên hiểu cùng một ý, schema là phần biến quy ước về cấu trúc thành những điều cụ thể: dữ liệu có những trường nào, mỗi trường chứa kiểu giá trị gì, trường nào bắt buộc và giá trị nào được xem là hợp lệ.
Với người làm tài chính đang học lập trình hoặc dùng AI để vibe coding, schema không phải một khái niệm hàn lâm. Nó là thứ giúp bạn trả lời ba câu hỏi rất thực tế:
- Tôi đang nhận được dữ liệu gì?
- Đoạn code có thể dựa vào những đặc điểm nào của dữ liệu?
- Khi nguồn hoặc thư viện thay đổi, phần nào trong quy trình có nguy cơ bị ảnh hưởng?
Schema dữ liệu là gì?
Schema dữ liệu là bản khai báo về cấu trúc và các quy tắc cơ bản của một tập dữ liệu. Có thể hình dung nó như mẫu biểu trống: chưa chứa số liệu của ngày hôm nay, nhưng đã nói rõ mỗi ô dùng để ghi gì và ghi theo cách nào.
Một schema thường mô tả:
- tên trường hoặc tên cột;
- kiểu dữ liệu, chẳng hạn chữ, số nguyên, số thực, đúng/sai hoặc thời gian;
- trường nào bắt buộc, trường nào có thể thiếu;
- một trường có được nhận giá trị rỗng hay không;
- tập giá trị cho phép, còn gọi là
enum; - cấu trúc lồng nhau hoặc quan hệ giữa các bảng;
- một số giới hạn như giá trị nhỏ nhất, lớn nhất hoặc định dạng ngày giờ.
Theo tài liệu chính thức, JSON Schema là một ngôn ngữ khai báo dùng để mô tả và kiểm tra cấu trúc, ràng buộc cùng kiểu dữ liệu của tài liệu JSON.1 Đây là một cách triển khai schema phổ biến, không phải cách duy nhất. Bảng dữ liệu trong Python, phản hồi của API và cơ sở dữ liệu đều có thể có schema dù chúng không dùng JSON Schema.
Điểm quan trọng là schema không phải dữ liệu thật.
Một phản hồi API như sau chỉ là một mẫu dữ liệu:
{
  "symbol": "FPT",
  "time": "2026-11-05T09:30:00+07:00",
  "close": 100.5,
  "side": "buy"
}
Nhìn vào mẫu này, ta có thể đoán close là số và time là thời gian. Nhưng một mẫu duy nhất chưa cho biết:
symbolcó luôn xuất hiện không;closecó thể bằngnullkhông;timecó bắt buộc kèm múi giờ không;sidengoàibuycòn nhận những giá trị nào;- giá
100.5đang tính bằng đồng, nghìn đồng hay một đơn vị khác.
Schema biến phần phải đoán thành phần được khai báo. Dưới đây là một bảng minh họa, không phải schema thực tế của một API cụ thể:
| Trường | Kiểu | Bắt buộc | Giá trị hợp lệ | Ghi chú |
|---|---|---|---|---|
symbol | Chuỗi | Có | Mã định danh hợp lệ | Viết hoa |
time | Thời gian | Có | Có thông tin múi giờ | Mốc của kỳ dữ liệu |
close | Số thực | Có | Không rỗng | Cần khai báo thêm đơn vị |
side | Chuỗi | Không | buy, sell, unknown | Không tự suy diễn giá trị lạ |
Chỉ cần thêm bảng này, người đọc và AI đã có cơ sở tốt hơn nhiều để viết bước kiểm tra trước khi tính toán.
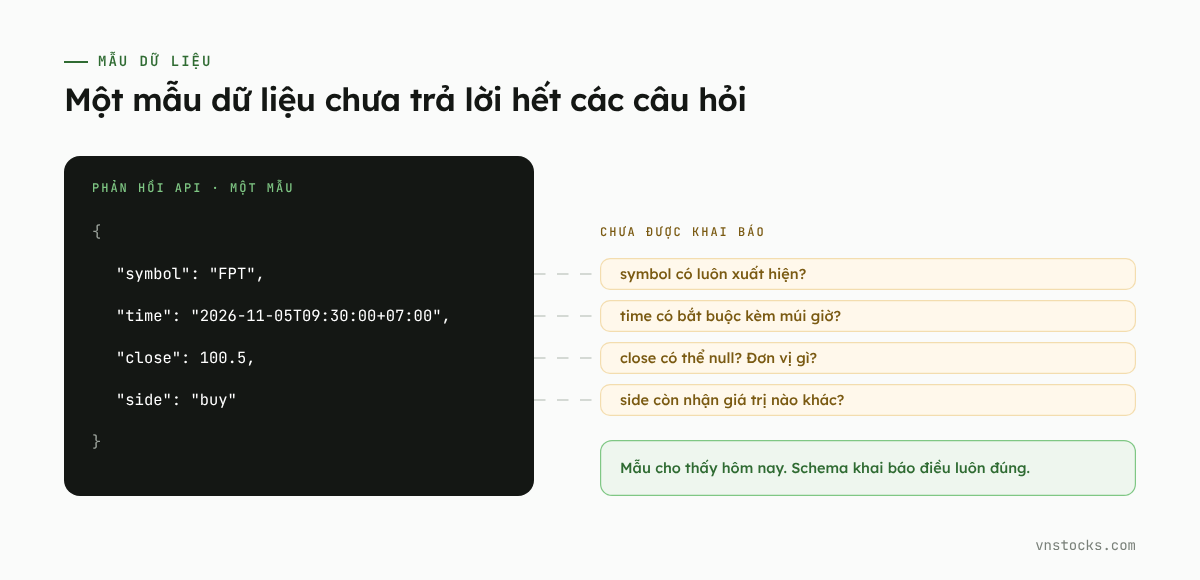 Mẫu dữ liệu chỉ là một ví dụ cụ thể, schema mới là bản khai báo các quy tắc chung
Schema xuất hiện ở đâu trong một ứng dụng?
Khi nghe từ schema, nhiều người chỉ nghĩ tới cơ sở dữ liệu. Thực tế cùng khái niệm này xuất hiện ở nhiều lớp của một ứng dụng. Chúng liên quan với nhau nhưng không phải là một.
| Nơi xuất hiện | Schema mô tả điều gì? | Ví dụ gần gũi |
|---|---|---|
| Hàm hoặc thư viện | Tham số đầu vào và cấu trúc kết quả trả về | Một hàm luôn trả bảng có time, open, high, low, close, volume |
| API endpoint | Dữ liệu được gửi lên và phản hồi nhận về | Tham số symbol là chuỗi; phản hồi là danh sách bản ghi giá |
| Tệp hoặc thông điệp | Cấu trúc của JSON, CSV hay sự kiện được truyền giữa hai chương trình | Một bản tin phải có mã, thời gian và loại sự kiện |
| Cơ sở dữ liệu | Bảng, cột, kiểu, khóa và quan hệ lưu trữ | Bảng tài sản liên kết với bảng lịch sử giá bằng mã định danh |
| Bảng phân tích | Tên cột, kiểu và quy ước của DataFrame | Cột thời gian có múi giờ; cột khối lượng dùng số nguyên |
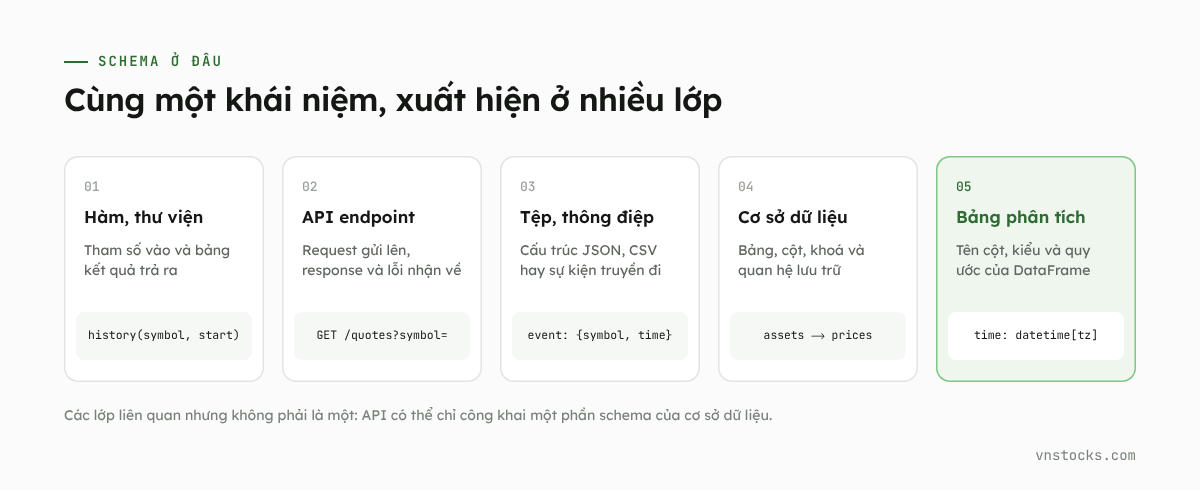 Cùng một khái niệm schema nhưng xuất hiện ở nhiều lớp khác nhau với phạm vi riêng
Schema của một hàm
Khi tài liệu nói một hàm trả về bảng có các cột cố định, đó là schema đầu ra của hàm. Người dùng có thể viết phần phân tích dựa trên các cột ấy mà không cần biết phản hồi ban đầu của từng nguồn được tổ chức ra sao.
Schema của hàm còn có thể mô tả đầu vào. Ví dụ, start và end phải là ngày, interval chỉ nhận một số giá trị cho phép, còn symbol là chuỗi bắt buộc. Nhờ vậy, lỗi có thể được phát hiện trước khi request được gửi đi.
Schema của API
Mỗi API endpoint thường có hai phía:
- request schema mô tả tham số hoặc nội dung người dùng gửi lên;
- response schema mô tả phản hồi khi thành công và các cấu trúc lỗi có thể nhận được.
Trong tài liệu OpenAPI, Schema Object được dùng để mô tả kiểu và cấu trúc dữ liệu trong một API.2 Khi phần này được viết đủ rõ, công cụ có thể dùng nó để sinh tài liệu, tạo client cho một số ngôn ngữ hoặc kiểm tra dữ liệu tự động.
Tuy nhiên, API có tài liệu schema không có nghĩa mọi ý nghĩa nghiệp vụ đã được giải thích. Khai báo close là số thực vẫn chưa cho biết đó là giá nào, đơn vị gì và đã điều chỉnh hay chưa. Đây là lúc data contract và tài liệu nghiệp vụ cần bổ sung cho schema.
Schema của cơ sở dữ liệu
Schema cơ sở dữ liệu mô tả cách dữ liệu được lưu: bảng nào tồn tại, bảng có những cột nào, khóa nào định danh một bản ghi và các bảng liên hệ với nhau ra sao.
Schema API và schema cơ sở dữ liệu không nên được mặc định là một. Cơ sở dữ liệu có thể lưu nhiều cột nội bộ nhưng API chỉ công khai một phần. Ngược lại, API có thể ghép dữ liệu từ nhiều bảng rồi trả về một cấu trúc thuận tiện hơn cho người dùng.
Việc tách hai lớp giúp phần lưu trữ được thay đổi mà không buộc mọi người dùng API phải sửa code, miễn là schema công khai của API vẫn được giữ tương thích.
Schema khác data contract như thế nào?
Hai khái niệm này thường được dùng cạnh nhau nên dễ bị trộn lẫn.
Schema trả lời: dữ liệu có đặc điểm nào và giá trị nào hợp lệ về mặt cấu trúc?
Data contract trả lời rộng hơn: các bên đã thống nhất điều gì về cấu trúc, ý nghĩa, đơn vị, chất lượng, thời gian, nguồn gốc và cách quản lý thay đổi?
Ví dụ, schema có thể khai báo:
close: số thực, bắt buộc, không được rỗngData contract cần nói thêm:
close: giá đóng cửa của cây nến, đơn vị nghìn đồng,
thuộc múi giờ Asia/Ho_Chi_Minh, chưa được tự thay bằng 0 khi thiếu dữ liệu
Schema là phần xương giúp chương trình kiểm tra được. Data contract bổ sung phần ý nghĩa để con người và chương trình dùng dữ liệu đúng mục đích. Một schema chặt nhưng thiếu ngữ nghĩa vẫn có thể tạo ra bảng “đúng kiểu, sai nghĩa”. Ngược lại, một tài liệu giải thích rất hay nhưng không khai rõ kiểu và giá trị hợp lệ khiến chương trình khó kiểm tra tự động.
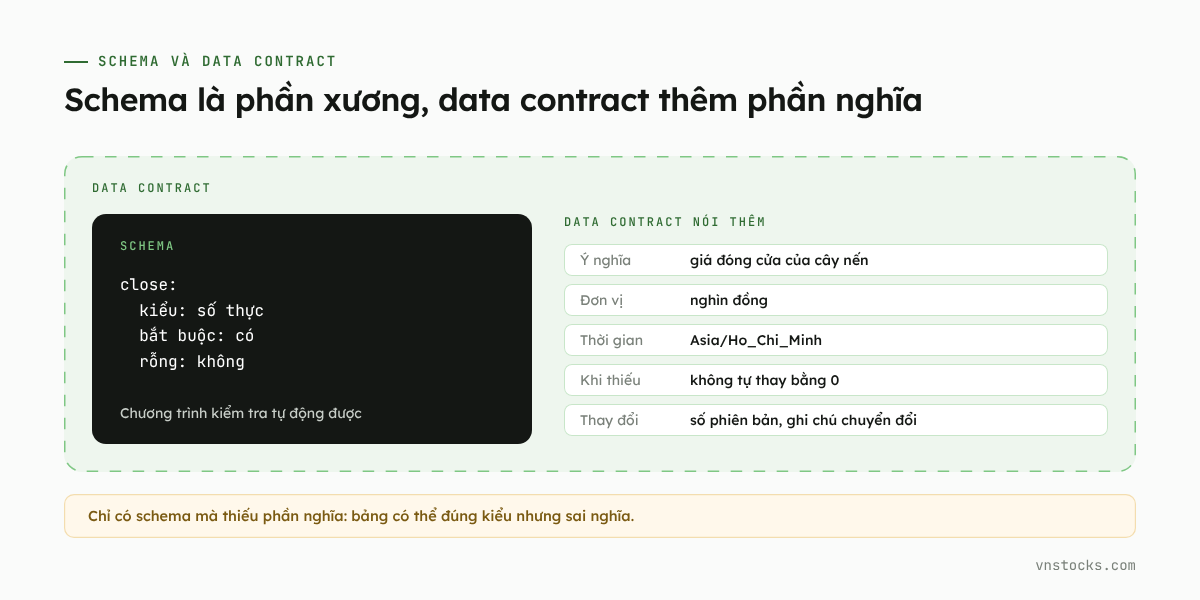 Schema kiểm tra tính hợp lệ về cấu trúc, data contract bảo đảm con người và AI hiểu đúng ngữ nghĩa
Vì vậy, hai lớp nên đi cùng nhau thay vì thay thế nhau.
Vì sao schema đặc biệt hữu ích khi dùng AI để viết code?
AI có thể viết cú pháp rất nhanh, nhưng không tự biết một quy ước chưa được cung cấp. Nếu chỉ gửi cho AI vài dòng JSON, nó sẽ suy luận từ mẫu nhìn thấy. Một trường hợp ngoại lệ chưa xuất hiện trong mẫu — như null, mã mới hoặc cấu trúc lồng thêm một cấp — có thể làm đoạn code hỏng.
Schema giúp thu hẹp khoảng trống đó theo bốn cách.
AI biết mình được phép dựa vào điều gì
Thay vì bảo “hãy đọc dữ liệu này”, bạn có thể nói rõ kết quả phải có các cột nào, kiểu gì và giá trị nào được phép xuất hiện. AI không phải tự đoán tên cột hoặc tự tạo quy ước riêng cho từng lần trò chuyện.
AI có thể viết bước kiểm tra trước bước phân tích
Khi đã có schema, bạn có thể yêu cầu AI:
- kiểm tra các cột bắt buộc;
- chuyển kiểu thời gian theo quy ước;
- phát hiện giá trị ngoài danh sách
enum; - phân biệt
0,nullvà trường không xuất hiện; - dừng quy trình nếu cấu trúc không còn tương thích.
Đây là khác biệt giữa “viết code để chạy với mẫu hôm nay” và “viết quy trình có khả năng nhận ra đầu vào đã thay đổi”.
Kết quả dễ kiểm thử và dùng lại
Một bài kiểm thử có thể dùng schema làm chuẩn. Nếu đổi nguồn dữ liệu, bộ chuyển đổi chỉ cần đưa đầu vào mới về cùng schema; phần tính toán phía sau có thể tiếp tục dùng lại.
Đó cũng là lý do schema hữu ích cho một nhóm không có nhiều lập trình viên. Người hiểu tài chính có thể cùng kỹ sư hoặc AI thống nhất bảng cấu trúc trước, rồi để công cụ hỗ trợ triển khai phần mã.
Cuộc trò chuyện với AI trở nên cụ thể hơn
Thay vì nhắc AI một cách mơ hồ rằng “dữ liệu này giống lần trước”, bạn có thể đưa cho nó schema hoặc đường dẫn tới tài liệu schema. Câu hỏi cũng trở nên tốt hơn:
Hãy kiểm tra đầu vào theo schema này trước. Nếu thiếu
timehoặcclose, gặpsidengoài danh sách cho phép, hoặc thời gian không có múi giờ thì dừng và giải thích lỗi. Chỉ tính toán sau khi dữ liệu hợp lệ.
Schema không bảo đảm AI luôn viết đúng. Nó cung cấp một mặt bằng rõ ràng để con người kiểm tra câu trả lời và để lần chạy sau có thể tái lập.
Từ phản hồi của nguồn tới schema ổn định hơn trong Vnstock
Vnstock cũng đi qua quá trình trưởng thành này.
Ở giai đoạn đầu của một thư viện kết nối dữ liệu, cách nhanh nhất để tạo giá trị là đọc phản hồi từ nguồn rồi đưa các trường đó thành bảng. Cách làm này giúp người dùng sớm truy cập được thông tin và phù hợp khi số hàm, số nguồn cùng lượng người dùng còn nhỏ.
Nhưng khi thư viện hỗ trợ nhiều nguồn hơn, phản hồi trực tiếp bắt đầu bộc lộ giới hạn. Hai nguồn có thể cùng nói về giá đóng cửa nhưng dùng hai tên trường. Một bên trả số, bên khác trả chuỗi. Cùng một trạng thái giao dịch có thể được viết hoa, viết thường hoặc dùng mã số. Nếu cấu trúc công khai của thư viện chỉ phản chiếu cấu trúc nguồn tại từng thời điểm, code của người dùng sẽ phải đổi theo từng nguồn và từng lần nguồn điều chỉnh.
Quá trình hoàn thiện vì thế diễn ra theo nhiều lớp.
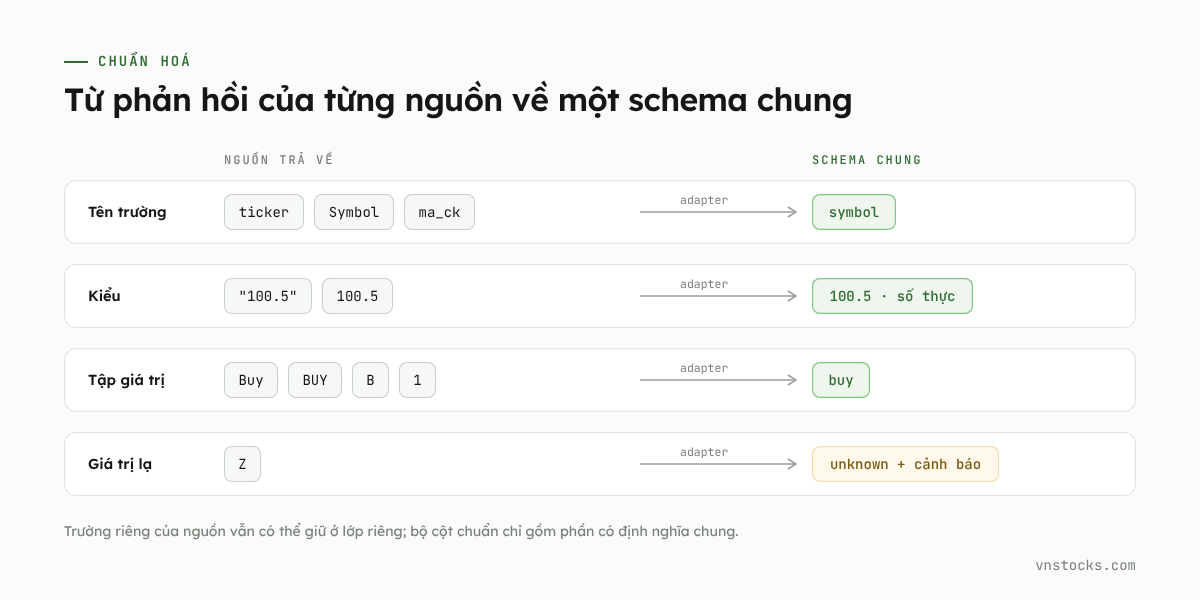 Từ phản hồi thô của nguồn đến schema chuẩn giúp giảm thiểu sửa đổi mã nguồn khi chuyển nguồn
Từ tên trường riêng sang quy ước đặt tên chung
Các trường cùng ý nghĩa cần được đưa về một cách gọi có thể dự đoán. Khi symbol luôn mang nghĩa mã định danh và volume luôn được phân biệt với giá trị giao dịch, người dùng có thể chuyển nguồn mà không phải viết lại toàn bộ phần phía sau.
Điều này không có nghĩa mọi trường từ mọi nguồn đều bị ép thành giống nhau. Trường riêng vẫn có thể được giữ ở lớp riêng, còn bộ cột chuẩn tập trung vào phần có định nghĩa chung.
Từ “đọc được” sang kiểu dữ liệu có quy ước
Một con số được API gửi dưới dạng chuỗi vẫn có thể hiển thị lên màn hình, nhưng sẽ gây khó khăn khi cộng, so sánh hoặc lưu vào cơ sở dữ liệu. Quy ước kiểu giúp kết quả dễ dự đoán hơn: đâu là chuỗi, số nguyên, số thực, giá trị đúng/sai và thời gian có múi giờ.
Kiểu dữ liệu cũng phải tính tới giá trị thiếu. Ví dụ, một cột số nguyên có ô trống cần cách biểu diễn khác với cột chắc chắn luôn có số. Đây là chi tiết nhỏ ở giao diện nhưng ảnh hưởng trực tiếp tới code phân tích.
Từ giá trị tự do sang tập giá trị thống nhất
Một trường trạng thái có thể nhận Buy, BUY, B, 1 hoặc một nhãn tiếng Việt tùy nguồn. Nếu mỗi đoạn code tự diễn giải, cùng một dữ liệu sẽ được xử lý theo nhiều cách.
Schema có thể khai báo tập giá trị chuẩn như buy, sell, unknown. Bộ chuyển đổi chịu trách nhiệm đưa giá trị của nguồn về tập chung; giá trị chưa nhận diện được phải được ghi nhận thay vì âm thầm đoán. Đây chính là vai trò của enum: giới hạn lựa chọn để người dùng và chương trình cùng biết trường hợp nào đã được dự kiến.
Từ tên dòng báo cáo sang taxonomy VAS có cấu trúc
Báo cáo tài chính là ví dụ cho thấy schema không dừng ở tên và kiểu cột. Cùng một khoản mục có thể được gọi khác nhau giữa nguồn, ngành hoặc giai đoạn; một dòng còn có vị trí, cấp cha-con, đơn vị và phạm vi riêng.
Vì vậy, chuẩn hóa báo cáo tài chính theo taxonomy cần thêm mã định danh ổn định, thứ tự, cấp phân loại, đơn vị và mẫu biểu phù hợp cho từng nhóm doanh nghiệp. Tên hiển thị có thể được cải thiện theo thời gian, còn mã mà chương trình sử dụng cần ổn định hơn để hạn chế việc người dùng phải sửa thuật toán.
Taxonomy có thể hiểu là một schema giàu ngữ nghĩa cho một miền dữ liệu cụ thể. Nó không chỉ nói “trường này là số”, mà còn giúp xác định “đây là khoản mục nào, nằm ở đâu trong báo cáo và có quan hệ gì với khoản mục khác”.
Từ thay đổi âm thầm sang thay đổi có dấu hiệu
Một schema hữu ích không chỉ mô tả hiện tại. Nó còn giúp nhận diện khi đầu ra không còn giống trước.
Trong định hướng Vnstock thế hệ 6, mỗi hàm có bộ cột chuẩn dùng chung giữa các nguồn; kết quả còn mang thông tin kèm theo để cho biết nguồn, thời điểm lấy, chế độ cột và những thay đổi schema liên quan. Khi một thay đổi có thể làm hỏng code cũ, cảnh báo và mã thay đổi giúp người dùng biết phần nào cần xem lại thay vì phải tự dò sau khi kết quả đã lệch.
Mục tiêu không phải đóng băng schema mãi mãi. Thị trường, nguồn dữ liệu và nhu cầu phân tích đều tiếp tục thay đổi. Mục tiêu thực tế hơn là làm cho thay đổi trở nên có chủ đích, có dấu hiệu và dễ chuyển đổi hơn.
Schema ổn định không có nghĩa là schema bất biến
Một schema tốt vẫn cần phát triển. Vấn đề là phân biệt loại thay đổi và quản lý tác động của nó.
| Loại thay đổi | Ví dụ | Mức ảnh hưởng thường gặp |
|---|---|---|
| Bổ sung tương thích | Thêm một trường tùy chọn mới | Code cũ thường vẫn chạy nếu không phụ thuộc vị trí cột |
| Siết quy tắc | Trường từng được để rỗng nay bắt buộc có giá trị | Có thể làm dữ liệu cũ không còn hợp lệ |
| Thay đổi phá vỡ tương thích | Đổi tên trường, đổi kiểu hoặc xóa trường | Code đang dùng trường cũ cần chuyển đổi |
| Thay đổi ngữ nghĩa | Giữ tên nhưng đổi đơn vị hoặc cách tính | Nguy hiểm vì code có thể vẫn chạy nhưng hiểu sai |
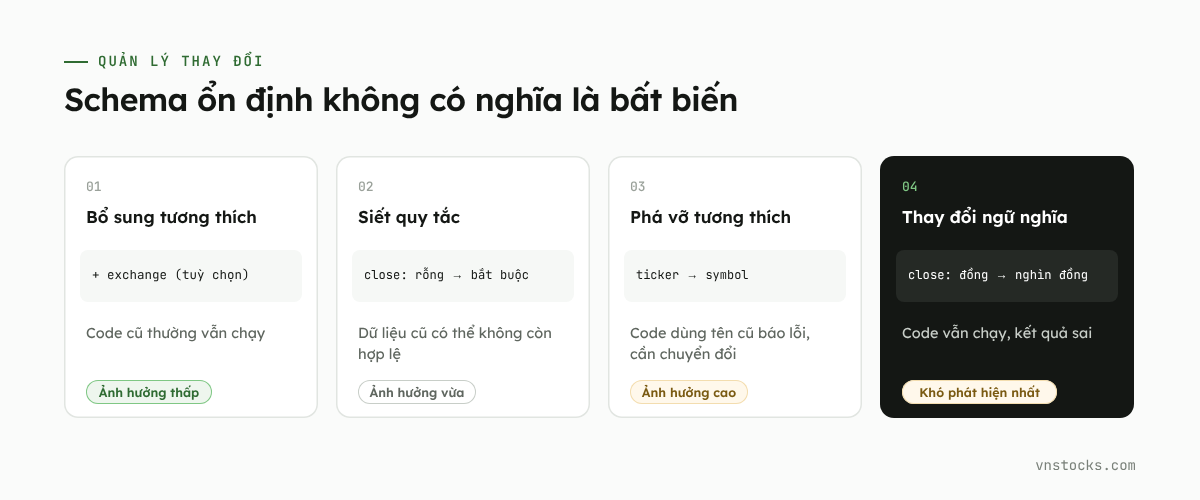 Bốn loại thay đổi schema và mức độ ảnh hưởng đến mã nguồn của người dùng
Thay đổi ngữ nghĩa thường khó phát hiện nhất. Nếu close vẫn là số thực nhưng đơn vị chuyển từ đồng sang nghìn đồng, trình kiểm tra kiểu không báo lỗi. Vì vậy schema cần đi cùng data contract, số phiên bản và ghi chú chuyển đổi.
Người dùng cũng có thể giảm rủi ro bằng cách:
- không dựa vào thứ tự cột nếu tài liệu không cam kết thứ tự;
- kiểm tra cột bắt buộc trước khi tính toán;
- lưu phiên bản thư viện và thời điểm lấy cùng kết quả;
- đọc cảnh báo khi nâng phiên bản;
- thử quy trình trên một tập dữ liệu nhỏ trước khi chạy lại toàn bộ lịch sử;
- giữ bước chuyển đổi nguồn tách khỏi bước tính toán.
Checklist schema dành cho vibe coder
Bạn không cần tự viết một tiêu chuẩn phức tạp ngay từ đầu. Với một quy trình cá nhân, hãy tạo một bảng schema nhỏ và trả lời các câu hỏi sau:
- Kết quả phải có những trường nào?
- Mỗi trường là chữ, số, đúng/sai hay thời gian?
- Trường nào bắt buộc và trường nào được phép rỗng?
- Có trường nào chỉ nhận một danh sách giá trị cố định không?
- Đơn vị của giá, khối lượng, tỷ lệ và thời gian là gì?
- Trường nào dùng làm mã định danh hoặc khóa để nối bảng?
- Nếu xuất hiện trường mới, giá trị lạ hoặc kiểu sai, quy trình sẽ cảnh báo hay dừng?
- Schema đang dùng thuộc phiên bản nào?
Sau đó, đưa bảng này cho AI và yêu cầu nó làm theo thứ tự:
1. Kiểm tra dữ liệu đầu vào theo schema.
2. Báo rõ trường thiếu, kiểu sai và giá trị ngoài enum.
3. Không tự thay null bằng 0 nếu chưa có quy ước.
4. Chỉ chuẩn hóa sau khi giải thích phép chuyển đổi.
5. Chỉ tính toán khi bước kiểm tra đã đạt.
Cách làm này chậm hơn vài phút ở lần đầu nhưng tiết kiệm đáng kể thời gian dò lỗi, đặc biệt khi quy trình được chạy lại nhiều lần hoặc chuyển cho người khác sử dụng.
Điều cần nhớ
Schema dữ liệu là bản khai báo giúp con người và chương trình biết dữ liệu được tổ chức ra sao. Nó có thể mô tả đầu vào và đầu ra của một hàm, request và response của API, cấu trúc bảng trong cơ sở dữ liệu hoặc bộ cột của một DataFrame.
Giá trị lớn nhất của schema không nằm ở việc dùng thêm một thuật ngữ kỹ thuật. Nó nằm ở khả năng biến những điều trước đây phải đoán thành quy tắc có thể đọc, kiểm tra và dùng lại. Lập trình viên viết code ít phụ thuộc vào mẫu ngẫu nhiên. AI có thêm ngữ cảnh để không tự đặt tên và kiểu dữ liệu. Người làm tài chính có cơ sở để hỏi đúng khi một con số không còn mang ý nghĩa như mong đợi.
Với Vnstock, hành trình từ phản chiếu đầu ra của từng nguồn tới quy ước tên, kiểu, enum, bộ cột chung và taxonomy VAS cũng là hành trình biến kinh nghiệm sử dụng thành cấu trúc có thể tái sử dụng. Schema sẽ còn phát triển, nhưng thay đổi cần ngày càng dễ nhận biết, dễ giải thích và ít buộc người dùng làm lại phần việc đã ổn định. Phần tiếp theo của chuỗi đi từ cấu trúc dữ liệu sang cách tổ chức mã nguồn: Naming convention là gì? Quy tắc viết code cho người và AI.
Nội dung phục vụ học tập, nghiên cứu và tham khảo, không phải khuyến nghị đầu tư. Dữ liệu người dùng truy cập qua công cụ vẫn đến từ nguồn bên thứ ba; phạm vi, schema và điều kiện sử dụng có thể thay đổi theo từng nguồn. Hãy đọc tài liệu hiện hành, tuân thủ điều kiện sử dụng và kiểm tra đầu vào trước khi phân tích.
Footnotes
-
JSON Schema mô tả mình là ngôn ngữ khai báo để định nghĩa cấu trúc và ràng buộc của dữ liệu JSON: What is JSON Schema? ↩
-
OpenAPI Specification định nghĩa Schema Object dùng để mô tả kiểu dữ liệu trong tài liệu API: OpenAPI Specification ↩